

はじめに
NRIの認定アプリケーションエンジニアの竹本です。
日ごろからAzureを利用して業務を取り組む中で、昨今の話題の中心はやはり生成AIです。「クローズドなネットワークで、業務データを活用してRetrieval-Augmented Generation (RAG)を構築したい」という話題で現在もちきりだと思います。
今まではRAG構築の際に、ストレージアカウントに元データを配置して、Azure AI Searchを使いINDEXを作成するという流れだったと思いますが、やはりコストメリットが出にくいことも多かったのではないかと思います。また、オープンソースのベクトルデータベースも多数存在しますが、データが増加するにつれて、必要な計算リソースも増加します。これに伴って、ストレージと計算リソース(サーバー、クラウドサービスなど)に対するコストが増大します。スケーラビリティが低い場合、追加の最適化作業が必要となり、これもコストに影響します。
Microsoft Build 2023でAzure Cosmos DB for MongoDB (vCore)を用いたベクトル検索がサポートされると発表されました。
ベクトル検索で実施すればコストメリットが出るのか、ぜひ試してみたいと思いました。実際に業務データを活用したRAGを構築し、社内の評判も良かったため、今回のブログで構築環境を紹介したいと思います。
Azure Cosmos DB for MongoDBについて
仮想コア アーキテクチャの Azure Cosmos DB for MongoDB は、Azure Cosmos DB for MongoDB 仮想コアの統合されたベクター データベースでは、埋め込みを元のデータと共に格納し、インデックス作成やクエリを実行できます。 この方法により、データを別の純粋なベクトル データベースに複製する余分なコストがかかりません。 さらに、このアーキテクチャではベクトル埋め込みと元のデータが一緒に保持されるため、マルチモーダル データの操作が簡略化され、データの整合性、スケーラビリティ、パフォーマンスを向上させることができます。
ベクター ストアとは
ベクトル ストアまたはベクトル データベースは、高ディメンション空間におけるデータの数学的表現であるベクトル埋め込みを格納および管理するように設計されたデータベースです。 この空間では、各ディメンションがデータの特徴に対応しており、高度なデータを表現するために数万ディメンションが使われる場合があります。 この空間内のベクトルの位置は、その特性を表します。 単語、フレーズ、ドキュメント全体、画像、オーディオ、その他の種類のデータはすべてベクトル化できます。
下記にも詳しく説明されています。
ベクトル ストア - Azure Cosmos DB for MongoDB vCore | Microsoft Learn
目指した構成
社内の業務用ノウハウをRAGに利用するため、クローズドネットワークと東日本リージョンのプライベートエンドポイントのみで構築していきます。
実際に登録した業務データはお見せできないためMSのサイトで公開されている「Microsoft Azure利用ガイド_2024年1月版(Azure_usage_guide.pdf)」を今回はベクトル化してみます。

実際に作ってみる
作成を進めていくと、コストの見積もりが途中で表示されます。
仮想コアモデルでは、データベース操作を行うノードごとに、仮想コア(コンピューティング能力とメモリ)に対して料金が発生します。この料金は、プロビジョニングされたノードのサイズや数によって決まります。
ディスクストレージに関しては、各ノードに割り当てられたストレージサイズに応じて料金が発生します。


GUI上では、他のtierを選んで高可用性のチェックをつけたままtierを下げると、チェックボックスを外せない点に注意が必要です。
このクラスターのグローバル分散を有効にして、データの読み取りレプリカを別の Azure リージョンに保持します。このリードレプリカは、プライマリ リージョンが使用できなくなった場合に使用できます。


完全にクローズドな環境での構築のためプライベートエンドポイントからのアクセスのみを許容します。
次にAzure Open AIですが、こちらもプライベートエンドポイントからの接続のみを許容します。
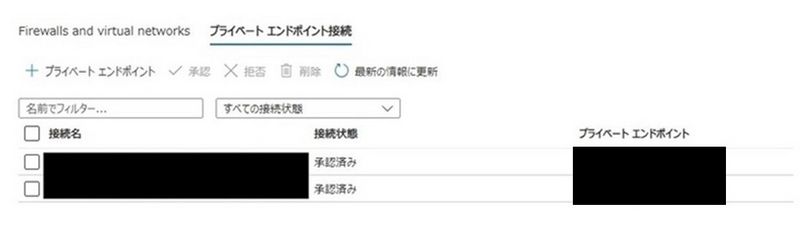

OpenAIのモデルについては以下の二つのモデルをデプロイします。
- gpt-4o
- text-embedding-ada-002
仮想マシン(VM)はこれらのエンドポイントに接続可能なVMであればなんでもよいです。
仮想マシンにjupiter-labを立ち上げておきます。
エンベディングの実施
「Microsoft Azure利用ガイド_2024年1月版」のPDFデータをページごとに分割して、ベクトル化していきます。

今回は以下のライブラリを利用して、ベクトル化します。

バージョンは以下で実施します。

本題とは少しずれますが完全にオフラインで動かすにはcl100k_base.tiktokenをローカルに持っておく必要があり、エンコーディング構造体を読み込む実装を行う必要があります。


PDFを読み込みます。この際にページごとにsplitしていきます。

読み込んで100ページ目を見ると以下のようになっています。

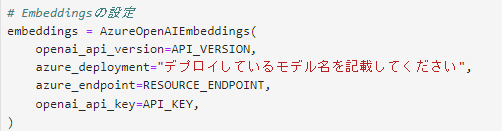
エンベディングの設定を行います。

次にCosmosMongDBへの接続を行います。

今回はPDF名、テキスト、エンベディングのコレクションとなるようにしました。エンベディングして、insertを行います。
元のドキュメント名を返却したい場面があると思いますのでembed_documentsを使用しています。

最後にindexの作成を行います。
vectorSearchIndexという名前のindexを作成します。Indexを張るプロパティはembeddingのため、そこにcosmosSearchでindexをつけていきます。

kind: 作成するベクター インデックスの種類、オプションは vector-ivf と vector-hnsw です。 vector-ivf はすべてのクラスター レベルで利用可能で、vector-hnsw は M40 クラスター レベル以上で利用できます。今回はM25で試しているためvector-ivfとなります。
numLists: この整数は、ベクター データをグループ化するために転置ファイル (IVF) インデックスによって使用されるクラスターの数です。 ドキュメント数が 100 万までの場合は numLists に documentCount/1000 を、100 万を超える場合は sqrt(documentCount) を設定することをお勧めします。 numLists の値に 1 を使用することは、パフォーマンスが制限されるブルート フォース検索を実行することと同様です。今回は100ドキュメントのため1で設定します。
Similarity:インデックスで使用する類似性メトリック。 可能なオプションは COS (コサイン距離)、L2 (ユークリッド距離)、または IP (内積)です。
dimensions:ベクトルの類似性の次元の数。 サポートされている次元の最大数は 2000 です。
※text-embedding-3-largeも現在は選択肢に上がりますが、3072次元のため最大次元数を超過します。もし利用する場合はtext-embedding-3-smallやtext-embedding-3-largeの次元数を下げて利用することが検討されます。筆者はtext-embedding-3-largeの次元数を下げて最新環境では利用中です。
※なお説明用のnotebookでは順を追って解説していますが、実際のバッチは特定ディレクトリ配下のpdfを一気にベクトル化可能です。
ベクトル検索及びgpt4oによる結果サマリ
ここまでできれば準備はOKなので次は検索を試していきます。
ライブラリは以下を利用します。

エンコーディング構造体の読込は先ほどと同様に実施します。
エンベディングの設定も先ほどと同様に実施し、VectorStoreの設定を行います。text_keyは先ほどのコレクションのtextとして、embedding_keyにembeddingを指定します。

では以下についての質問をしてみます。

K=7で検索し、結果を結合します。

gpt4oに回答をお願いしてみます。
できる限りハルシネーションが抑えられるようにプロンプトのチューニングを行うのが良いと思います。

結果は以下です。なかなかよいまとめが出力されています。

まとめ
AzureのAzure Cosmos DB for MongoDB (vCore)を使ってこんなに簡単にクローズドな環境でRAGが構築可能でした。速度も非常に速く低コストに運用できるため社内RAGの構築に最適だと思います。クローズドなネットワークで、RAGを構築したいと思っている方々にとって、本記事が参考になれば幸いです。
お問い合わせ
atlax では、ソリューション・サービス全般に関するご相談やお問い合わせを承っております。
 お問い合わせ
関連リンク・トピックス
・atlax / クラウドの取り組み / Microsoft Azure
・2023/12/19 Data Lake Houseって何だろう?Azure Databricksをつくってみる
-

採用情報
NRIの IT基盤サービスでは、キャリア採用を実施しています。様々な職種で募集しておりますので、ご興味を持たれた方は キャリア採用ページも ぜひご覧ください。
※ 記載された会社名 および ロゴ、製品名などは、該当する各社の登録商標または商標です。
※ アマゾン ウェブ サービス、Amazon Web Services、AWS および ロゴは、米国その他の諸国における、Amazon.com, Inc.またはその関連会社の商標です。
※ Microsoft、Azure は、米国 Microsoft Corporation の米国およびその他の国における登録商標または商標です。
※ Google Cloud、Looker、BigQuery および Chromebook は、Google LLC の商標です。
※ Oracle、Java、MySQL および NetSuite は、Oracle Corporation、その子会社および関連会社の米国およびその他の国における登録商標です。NetSuite は、クラウド・コンピューティングの新時代を切り開いたクラウド・カンパニーです。
